Q초보자도 교재 없이 수강 가능한가요? 프로그램 정보는?
A
네, 영상과 실습자료로 쉽게 학습할 수 있습니다. 알지오는 원격평생교육원으로 프로그램 관련 정보는 제공하지 않습니다.
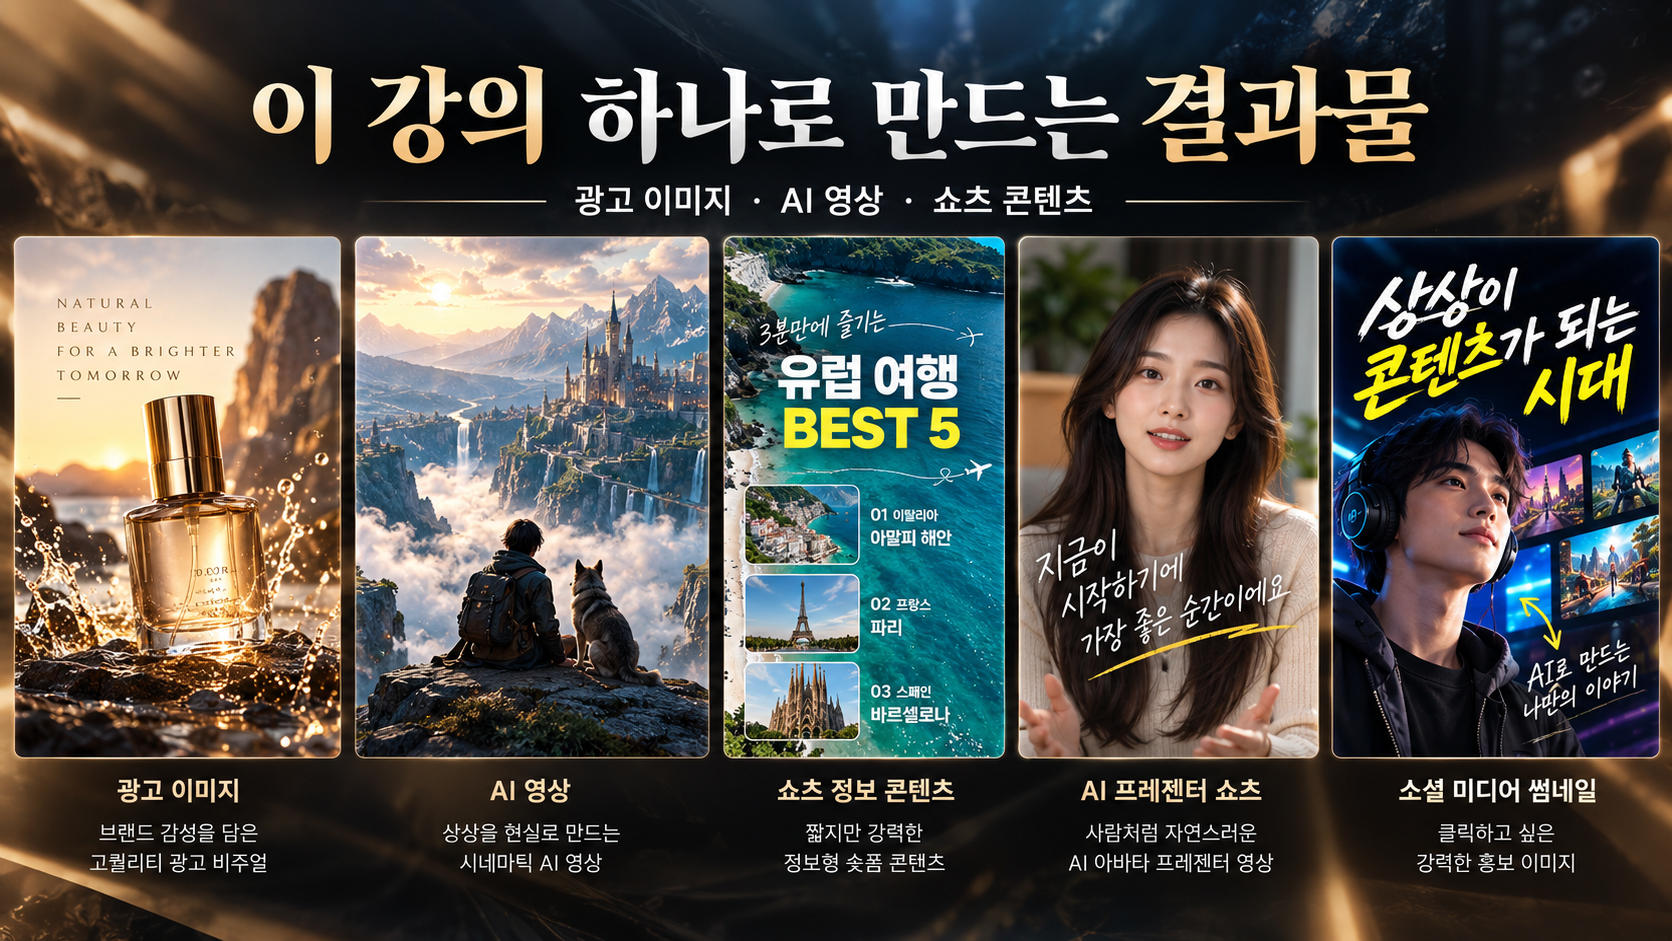
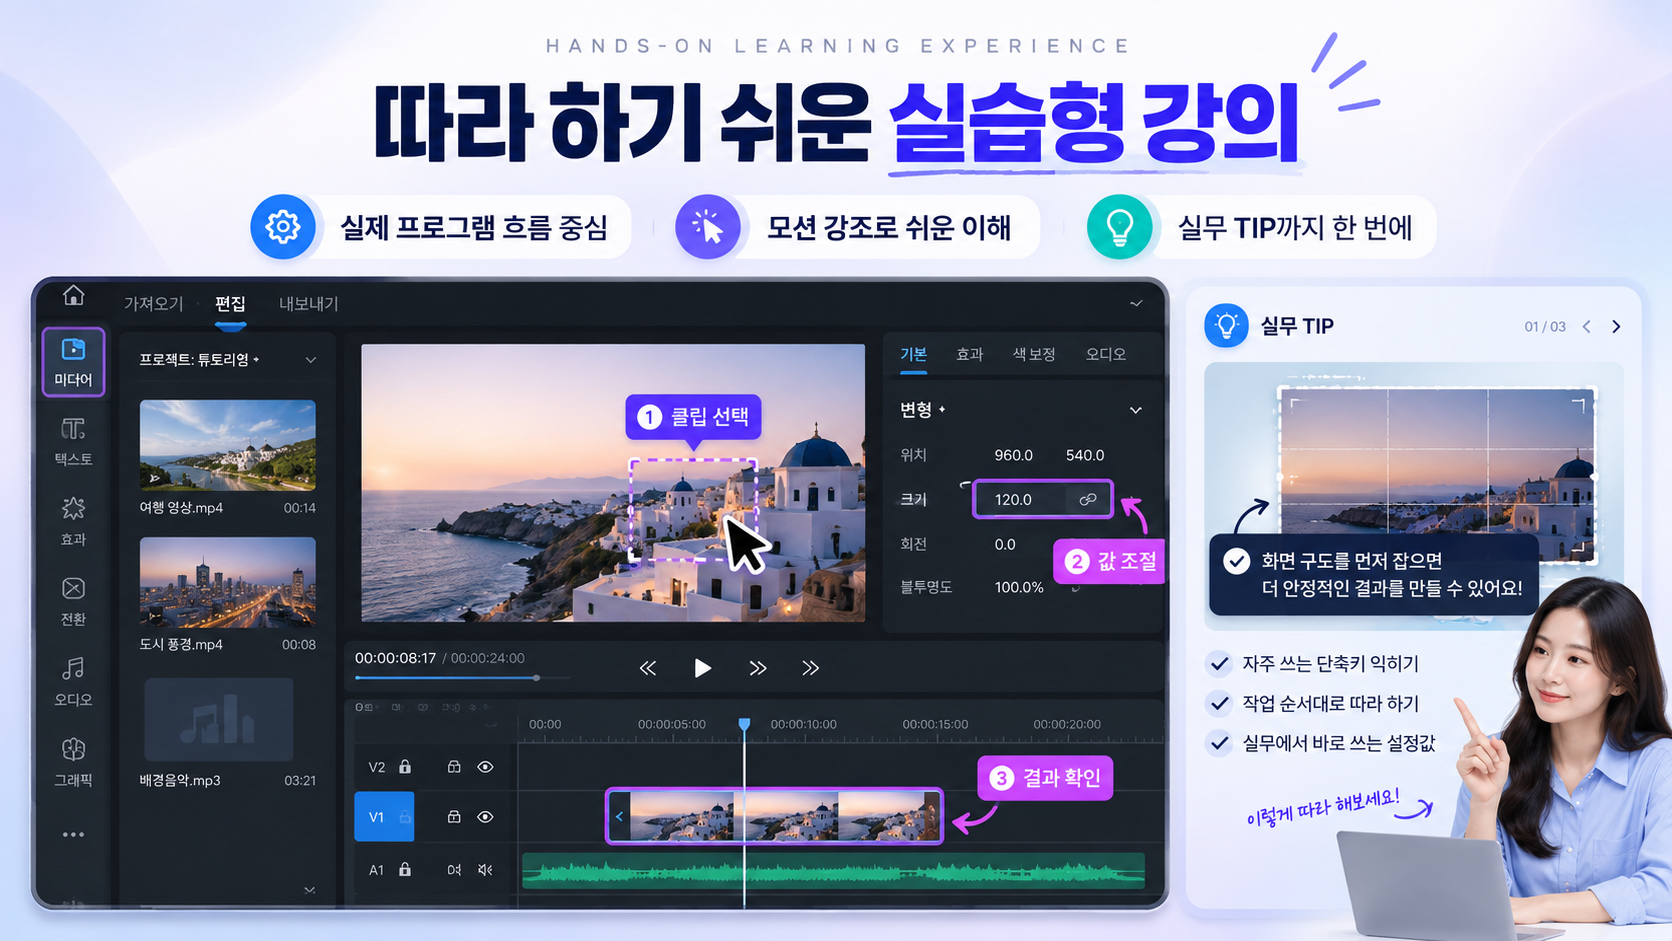
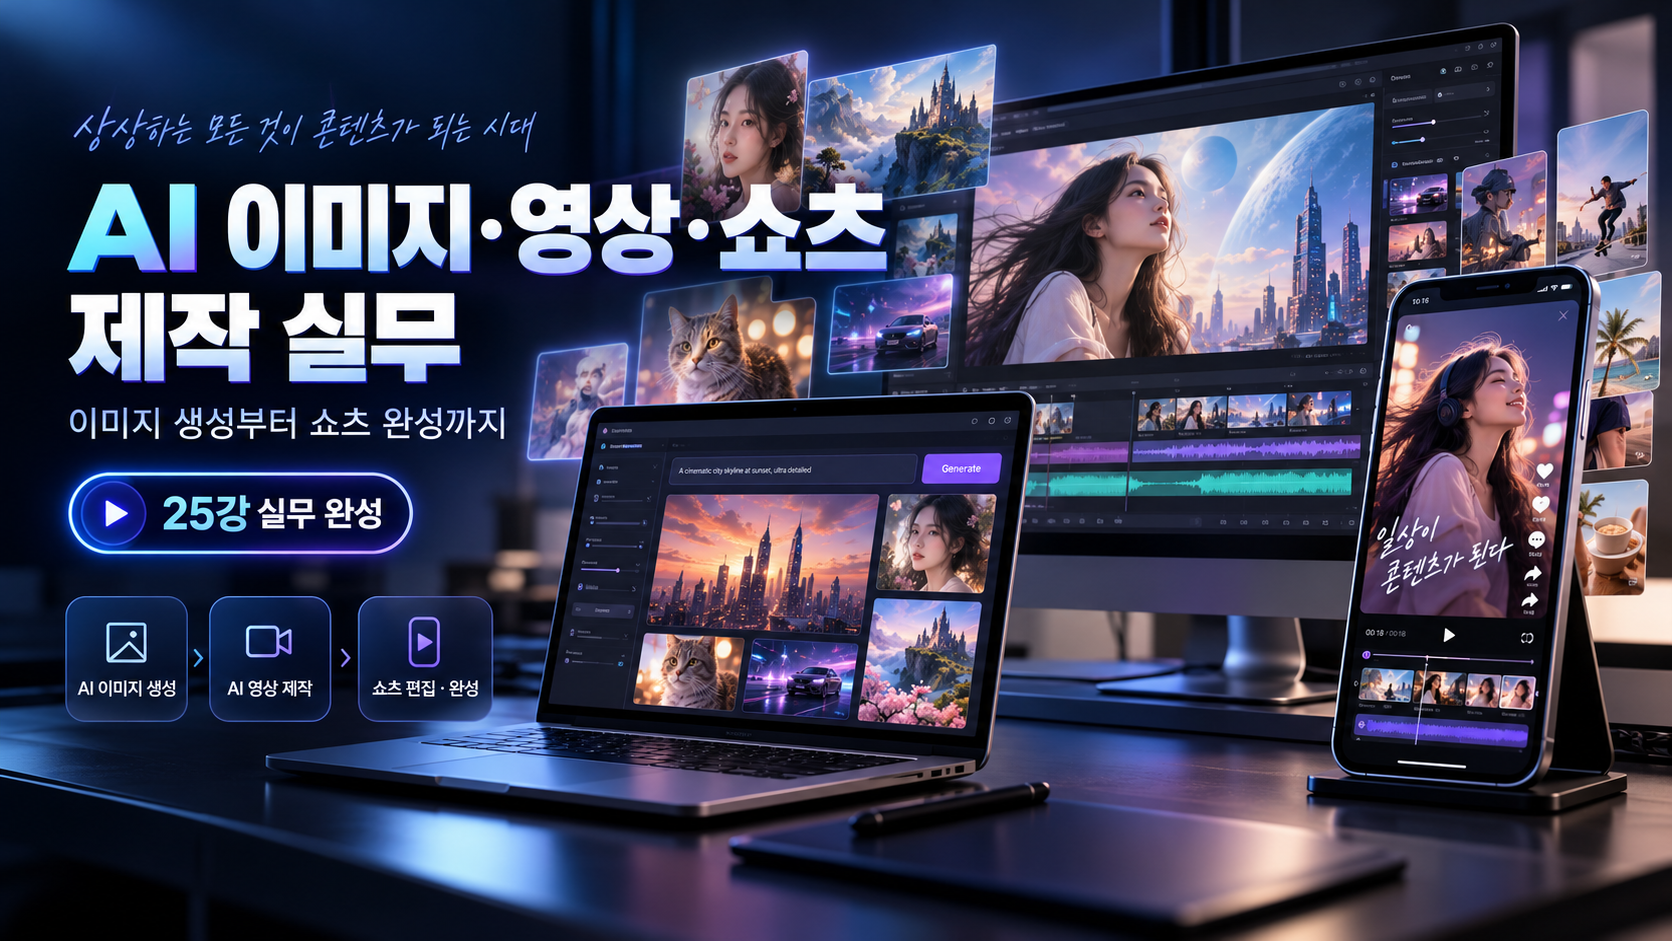
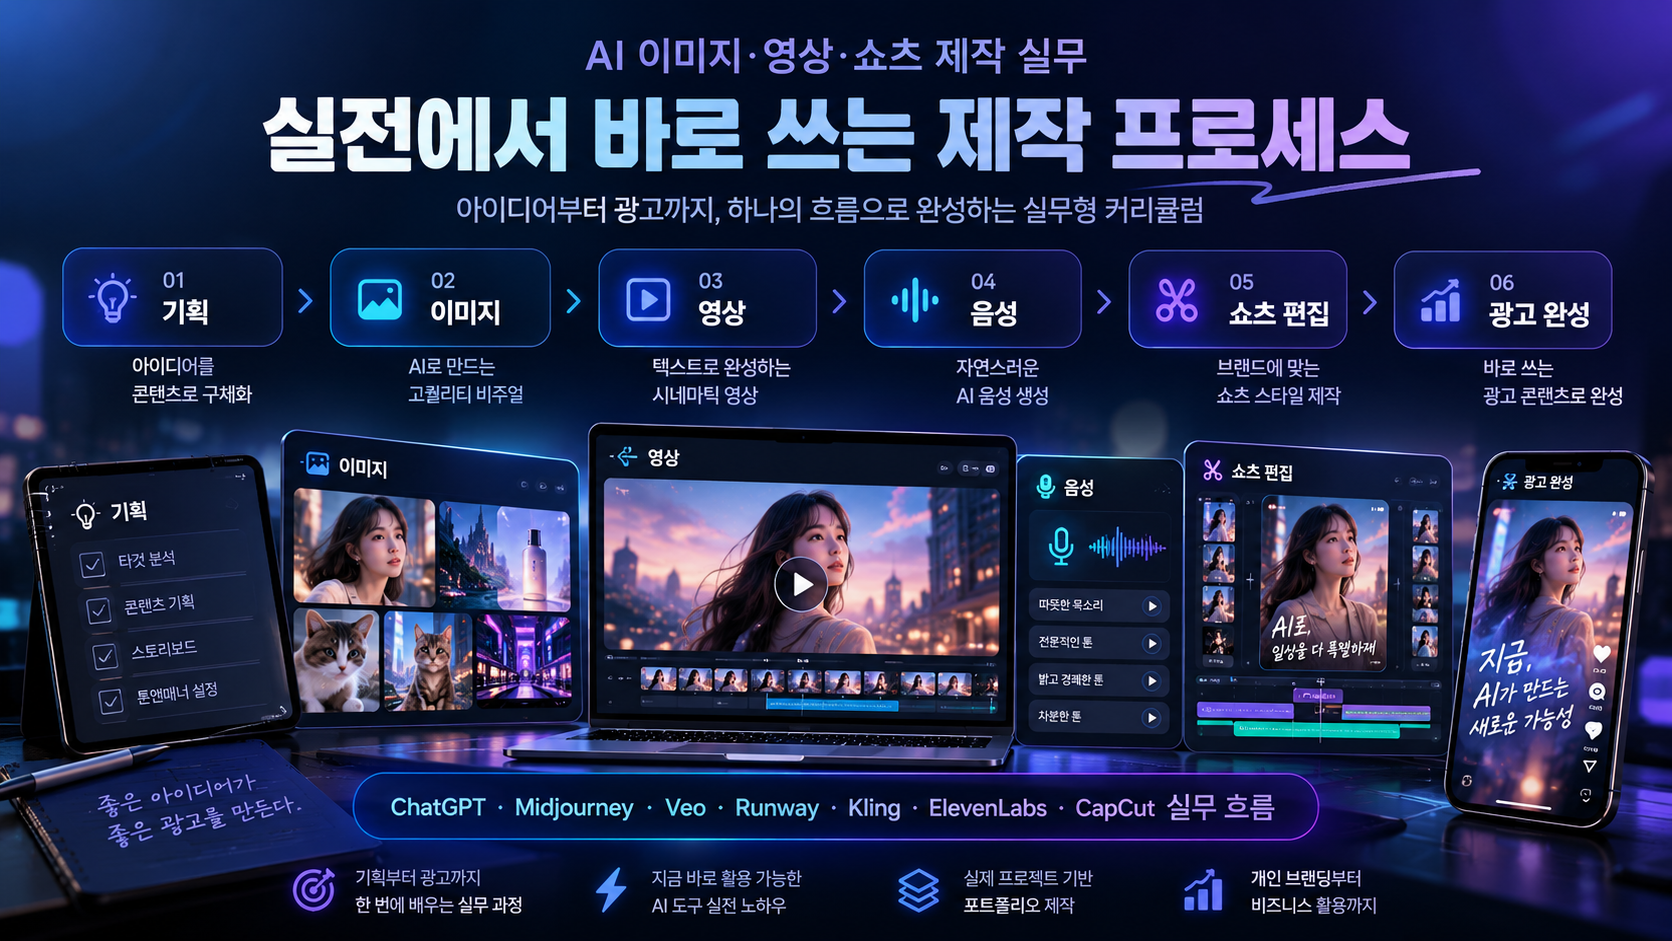
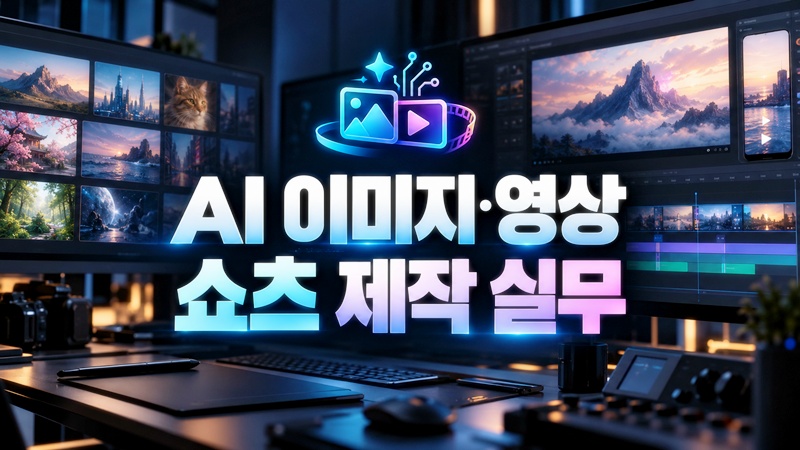
AI 이미지·영상·쇼츠 제작 실무는 공개 목차 25강을 기준으로 이미지 생성부터 영상·음성·쇼츠 편집까지 순서대로 학습합니다. 1~9강은 ChatGPT·Gemini·Midjourney로 인물·캐릭터·제품·홍보 이미지를 만들고 영상용 소스를 준비합니다. 10~17강은 콘티와 장면 이미지, Veo·Runway·Kling 영상 생성·변환, 캐릭터 연속 장면과 오류 수정을 다룹니다. 18~19강은 ElevenLabs 내레이션과 음악·효과음을 준비하며, 20~25강은 쇼츠 대본과 VREW·CapCut 편집을 거쳐 정보형·말하는 캐릭터·상품 광고 쇼츠의 최종 MP4 제작으로 이어집니다. 관련 과정은 챗GPT·생성형 AI(/chatgpt/)와 영상편집(/video-editing/) 허브에서 비교할 수 있습니다.
관련 분야 전체 과정영상 편집 전문 전체 과정 보기 → · 챗GPT·생성형 AI 교육
수강 전 자주 묻는 내용을 간단히 안내드립니다.
네, 영상과 실습자료로 쉽게 학습할 수 있습니다. 알지오는 원격평생교육원으로 프로그램 관련 정보는 제공하지 않습니다.
검증된 커리큘럼과 전문 강사진으로 높은 만족도를 제공합니다.
자세히 보기 >작은 나눔이 더 나은 내일을 만듭니다.
자세히 보기 >실제 수강생의 학습 경험을 확인해 보세요.
수강후기를 불러오는 중입니다.
최근 등록된 수강질문을 작성순서대로 확인해 보세요.
같은 학과에서 함께 학습하면 좋은 강의를 모았습니다.
1~9강은 이미지 생성·수정과 영상용 소스 준비, 10~17강은 콘티와 AI 영상 생성·변환·오류 수정, 18~19강은 내레이션과 사운드, 20~25강은 쇼츠 기획·편집과 유형별 완성으로 이어집니다.
1~9강은 이미지 생성·수정과 영상용 소스 준비, 10~17강은 콘티와 AI 영상 생성·변환·오류 수정, 18~19강은 내레이션과 사운드, 20~25강은 쇼츠 기획·편집과 유형별 완성으로 이어집니다.
이미지 파일, 장면별 영상, 음성 트랙과 자막을 단계별로 정리하고 마지막 상품 광고·홍보 쇼츠의 최종 MP4로 연결하는 순서로 학습하세요. 공개 목차 25강을 기준으로 안내합니다.
텍스트로 인물·풍경·제품 이미지를 만들며 배경·구도·조명·스타일과 화면비를 지정합니다. 결과가 목적에 맞지 않으면 프롬프트를 수정하고 최종 이미지를 저장합니다.
2강은 기존 사진의 배경 교체, 인물·사물 추가와 삭제, 의상·색상 변경과 합성을 다룹니다. 3강은 참조 이미지를 업로드해 얼굴·의상·제품 형태를 유지하면서 포즈와 배경을 바꾸고 같은 인물의 여러 장면을 제작합니다.
사진 구도·렌즈 표현·조명·색감·배경을 프롬프트에 반영하고 변형과 업스케일 결과를 비교합니다. 실사 인물·제품·풍경 이미지의 표현 요소를 분리해 조정하는 연습입니다.
캐릭터 기준 이미지를 정한 뒤 얼굴·의상·스타일을 참조하며 전신·반신·클로즈업을 구성합니다. 장소와 포즈가 달라져도 인물의 특징이 유지되는지 여러 이미지를 함께 비교하세요.
AI 인물의 헤어·의상·표정·포즈를 바꾸고 스튜디오·야외 장면과 제품 사용 이미지를 제작합니다. 제품 원본을 활용한 배경 합성과 촬영 효과는 상세페이지용 상품 이미지 제작으로 이어집니다.
포스터·배너·유튜브 썸네일에서는 광고 문구와 이미지·텍스트 배치를 다룹니다. 16:9·9:16·1:1 화면마다 주요 피사체와 문구가 어떻게 배치되는지 점검하고 목적별 출력본을 구분합니다.
이미지 오류와 화질을 점검한 뒤 영상 시작·종료 이미지, 인물과 배경을 구분한 소스를 준비합니다. 장면별 파일을 정리하면 영상 생성 단계에서 입력 자료를 정확히 선택할 수 있습니다.
ChatGPT로 광고·쇼츠 대본을 쓰고 장면별 컷으로 나눕니다. 카메라 위치·움직임과 스토리보드 이미지를 연결해 각 장면에서 생성할 영상의 프롬프트를 완성합니다.
텍스트 기반 영상 생성에서 인물의 행동·배경과 카메라 이동·줌·회전을 설정하고 여러 결과를 비교해 저장합니다. 같은 장면을 반복 생성할 때 바꾼 조건과 결과를 함께 정리하세요.
이미지 기반 영상 생성에서는 표정·걷기·제품 움직임과 카메라 확대·이동을 다룹니다. 9:16 세로 영상으로 만들 때 입력 이미지의 피사체가 장면 안에서 유지되는지 확인합니다.
정지 이미지를 업로드해 인물·풍경의 움직임을 만들고 팬·틸트·돌리·트래킹 카메라 연출을 적용합니다. 카메라의 이동과 피사체의 동작을 구분해 자연스러운 컷을 구성합니다.
기존 영상을 불러와 배경·분위기와 실사·애니메이션 스타일을 바꾸고 움직임을 보완합니다. 변환 전후 장면을 비교한 뒤 사용할 결과를 선택해 편집합니다.
Kling의 텍스트·이미지 기반 생성으로 인물 동작·제품 회전·사물 이동을 표현하고 시작·종료 프레임과 카메라 움직임을 결합합니다.
동일 캐릭터의 연속 영상은 기준 이미지, 외형·의상, 장면 사이 움직임을 대조하며 연결합니다. 얼굴·손·사물 변형이나 걷기 오류가 있으면 프롬프트를 고치고 문제 장면을 분할·재생성해 사용할 컷을 정리합니다.
한국어 AI 목소리를 선택하고 대본의 감정·속도·억양을 조절해 문장별 음성을 만듭니다. 장면 길이와 음성 길이를 비교하며 영상에 맞는 내레이션 파일을 준비합니다.
AI 음악·효과음을 만들고 장면 전환과 동작에 맞춰 배치합니다. 내레이션과 BGM 음량을 조절한 뒤 말소리와 효과음이 겹치는 구간을 확인해 음성 트랙을 완성합니다.
30초·45초·60초 구성에서 첫 3초 훅, 장면별 대본, 반전·정보·스토리형 전개를 정리합니다. 대본에 필요한 이미지와 음성 자료를 먼저 준비하세요.
VREW에서는 대본·AI 음성과 자동 자막, 이미지·영상·BGM을 결합해 9:16 MP4로 출력합니다. CapCut에서는 컷 편집, 텍스트 애니메이션, 확대·축소·이동, 전환·효과음·속도 조절로 세로 영상을 편집합니다.
정보형 쇼츠는 주제를 정하고 45초 대본, AI 이미지·영상, 내레이션과 자막을 합성해 핵심 정보를 강조합니다. 제목과 썸네일까지 함께 제작하는 흐름을 학습합니다.
말하는 캐릭터 쇼츠는 캐릭터·배경 이미지와 ElevenLabs 음성을 준비해 립싱크 영상을 만듭니다. 표정·손동작·장면 변화와 자막·효과음을 결합해 가상 진행자가 등장하는 쇼츠로 정리합니다.
상품·서비스를 선정해 광고 대본과 콘티를 쓰고 제품·모델 이미지를 준비합니다. Veo·Runway·Kling으로 생성한 영상에 음성·음악·자막·로고를 결합해 15초·30초 광고 쇼츠와 최종 MP4를 완성하는 순서입니다.
이미지·영상·음성·자막의 연결 상태를 최종 출력본에서 확인하세요. 생성형 AI 활용 과정은 챗GPT 허브, 타임라인 편집과 후속 편집 과정은 영상편집 허브에서 공개 목차를 비교할 수 있습니다.

 165,000원
수강 전 자주 묻는 내용을 간단히 안내드립니다.
네, 영상과 실습자료로 쉽게 학습할 수 있습니다. 알지오는 원격평생교육원으로 프로그램 관련 정보는 제공하지 않습니다.